阿里国际站测试13款 AI 模型:最佳仅完成61.7%真实商贸任务
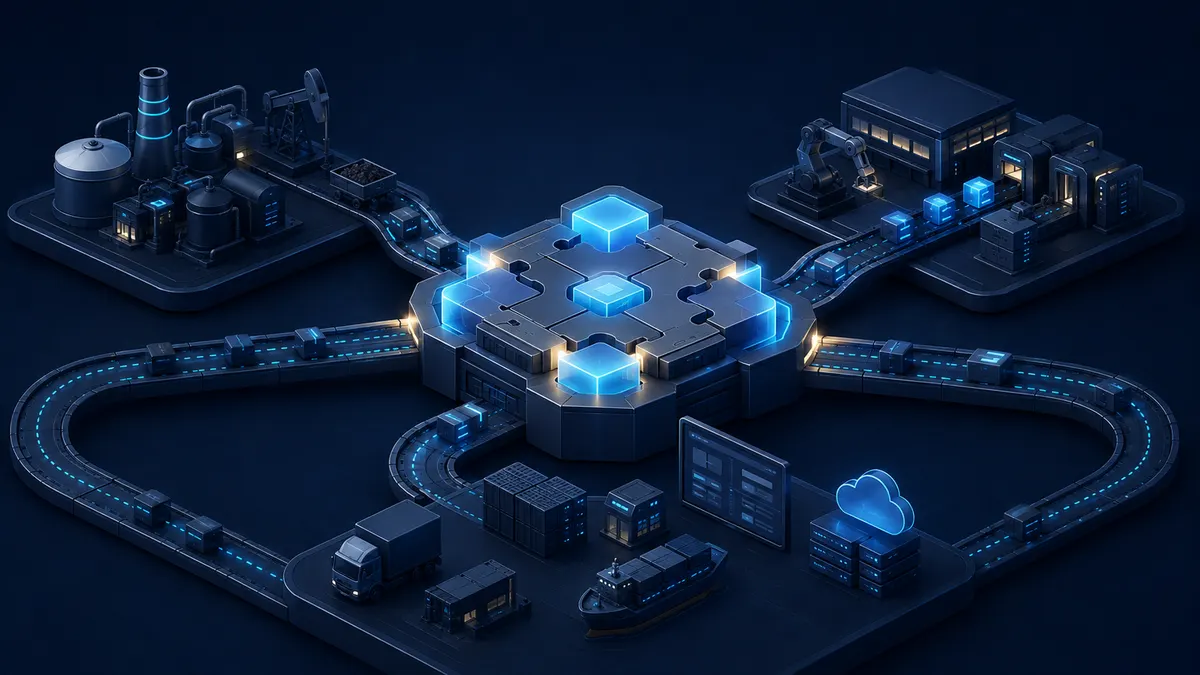
阿里巴巴国际站(Alibaba.com)在 GitHub 发布公开测试工具 CommerceAgentBench,对13个 AI 模型家族在107项真实商贸任务上的表现进行评分,结果于2026年9月公布。测试采用通过/不通过制,仅当任务正确完成才计分,例如商品须以正确属性上线、货运须预订在真实存在的航线上。
得分最高的是 Claude Opus 5,任务完成率为61.7%。阿里国际站总裁张阔9月9日在《财富》撰文称,这一分数「高到足以有用,也低到足以构成警示」。测试覆盖采购、物流、商品上架、履约及售后服务等环节。
据测试结果,AI 代理在到岸成本核算、退货纠纷和多段运输路线等需要跨多步骤保持信息的任务上表现最差。另据 PYMNTS Intelligence 数据,约1.32亿美国成年人曾在 AI 辅助下购买零售商品,其中亚马逊占此类购买的59%。
来源:https://www.pymnts.com/news/artificial-intelligence/2026/commerce-test-shows-where-ai-agents-break-down/
这篇内容的出处与状态
- 署名
- OceanAlt 编辑部
- 首次发布
- 2026-09-19
- 最后更新
- 2026-10-05
- 内容性质
- 快讯
- 原始资料
- 查看原文 ↗
相关阅读
付款前把收款地址粘进去,看它有没有上过制裁名单、混币器或诈骗标签。